Site cover image

Site icon imageSen(Qian)’s Memo

This website is Donglin Qian (Torin Sen)’s memo, especially about machine learning papers and competitive programming.

EM Algorithmの解説

このQiitaの記事やこのブログを参考に書いた。

ELBOという重要な概念についてはここを参考 📄Arrow icon of a page linkELBOとEM Algorithmについて

ELBOについて

ELBOとは、以下のようなもの。

ELBO=Eq(z∣x)[log⁡p(x,z)−log⁡q(z∣x)]=Eq(z∣x)[log⁡p(x∣z)]+Eq(z∣x)[log⁡p(z)−log⁡q(z∣x)]ELBO = \mathbb{E}_{q(z|x)} [\log p(x,z) - \log q(z|x)] \\ = \mathbb{E}_{q(z|x)} [\log p(x|z)] + \mathbb{E}_{q(z|x)} [\log p(z) - \log q(z|x)]

対数尤度

基本的には尤度は非常に大きい、小さい値を扱うことを考えて、計算精度の問題上、対数で扱う。

データ XX の背後にあるパラメタ θθ を学習したい。しかし、隠れパラメタがある都合上上手くこのままでは難しい。

ここで、隠れパラメタ ZZだとする。以下のように周辺確率に分解でき、対数を取る事ができる。

p(X∣θ)=∫p(X,Z∣θ)dZlog⁡p(X∣θ)=log⁡∫p(X,Z∣θ)dZ p(\mathbf{X} | \theta) = \int p(\mathbf{X}, \mathbf{Z} | \theta) d \mathbf{Z} \\\\ \log p(\mathbf{X} | \theta) = \log \int p(\mathbf{X}, \mathbf{Z} | \theta) d \mathbf{Z} 

実際には、隠れ変数ZZは明示的に設計者が決めなければならない。なぜならば、以降のEステップもMステップも明確にZZについての条件付確率、条件付期待値を求めるためである。

しかし、 log ∫log ∫は扱いづらい!(以下の参考資料では log Σlog Σとなっている)。ここで、いい感じの関数 q(Z)q(Z)を導入することで、以下のように式変形できる。なお、 qqが何であるかは明示的に決める必要はない。以下のEステップで自明に決まるからである。

∫q(Z)p(X,Z∣θ)q(Z)dZ=Eq(Z)[p(X,Z∣θ)q(Z)]\int q(\mathbf{Z}) \frac{p(\mathbf{X}, \mathbf{Z} | \theta)}{q(\mathbf{Z})} d \mathbf{Z} = \mathbb{E} _{q(\mathbf{Z})} [ \frac{p(\mathbf{X}, \mathbf{Z} | \theta)}{q(\mathbf{Z})} ]

このように、 q(Z)q(Z)についての期待値に変形できる。

そして、 loglog が上に凸の関数であるので、イェンゼンの不等式を用いると以下のように変形できる。汎関数 Lℒという変分下限を得ることができる。

log⁡E[X]≤E[log⁡X]log⁡∫q(Z)p(X,Z∣θ)q(Z)dZ=log⁡Eq(Z)[p(X,Z∣θ)q(Z)]≥Eq(Z)[log⁡p(X,Z∣θ)q(Z)]=∫q(Z)log⁡p(X,Z∣θ)q(Z)dZ=L(q,θ)\log \mathbb{E} [X] \leq \mathbb{E} [\log X] \\\\ \log \int q(\mathbf{Z}) \frac{p(\mathbf{X}, \mathbf{Z} | \theta)}{q(\mathbf{Z})} d \mathbf{Z} = \log \mathbb{E} _{q(\mathbf{Z})} [ \frac{p(\mathbf{X}, \mathbf{Z} | \theta)}{q(\mathbf{Z})} ] \\\\ \geq \mathbb{E} _{q(\mathbf{Z})} [ \log \frac{p(\mathbf{X}, \mathbf{Z} | \theta)}{q(\mathbf{Z})} ] = \int q(\mathbf{Z}) \log \frac{p(\mathbf{X}, \mathbf{Z} | \theta)}{q(\mathbf{Z})} d \mathbf{Z} = \mathcal{L}(q, \theta)

ELBOとの関係について

ELBOは、以下のように定義されている。

ELBO=Eq(z∣x)[log⁡p(x,z)−log⁡q(z∣x)]=Eq(z∣x)[log⁡p(x∣z)]+Eq(z∣x)[log⁡p(z)−log⁡q(z∣x)]ELBO = \mathbb{E}_{q(z|x)} [\log p(x,z) - \log q(z|x)] \\ = \mathbb{E}_{q(z|x)} [\log p(x|z)] + \mathbb{E}_{q(z|x)} [\log p(z) - \log q(z|x)]

上の得られた変分下限は、以下のようになる。

Eq(Z)[log⁡p(X,Z∣θ)q(Z)]=Eq(Z)[log⁡p(X,Z∣θ)−log⁡q(Z)]\mathbb{E} _{q(\mathbf{Z})} [ \log \frac{p(\mathbf{X}, \mathbf{Z} | \theta)}{q(\mathbf{Z})} ] = \mathbb{E}_{q(\mathbf{Z})} [\log p(\mathbf{X, Z}|\theta) - \log q(\mathbf{Z})]

ここでは、本来のELBOと違うのは、q(z∣x)→q(Z)q(z|x) \to q(\mathbf{Z})である。

  • ELBOでは、変分推論で使われているq(z∣x)q(z|x)は、本来わからないp(z∣x)p(z|x)の代替となるような分布を人が選んでそのパラメタをいじって学習させている。
  • EM Algorithmでは、q(Z)q(\mathbf{Z})はただの関数であり、特にp(Z)p(\mathbf{Z})やp(Z∣X,θ)p(\mathbf{Z|X}, \theta)を近似するために選んだわけではない。

差分について

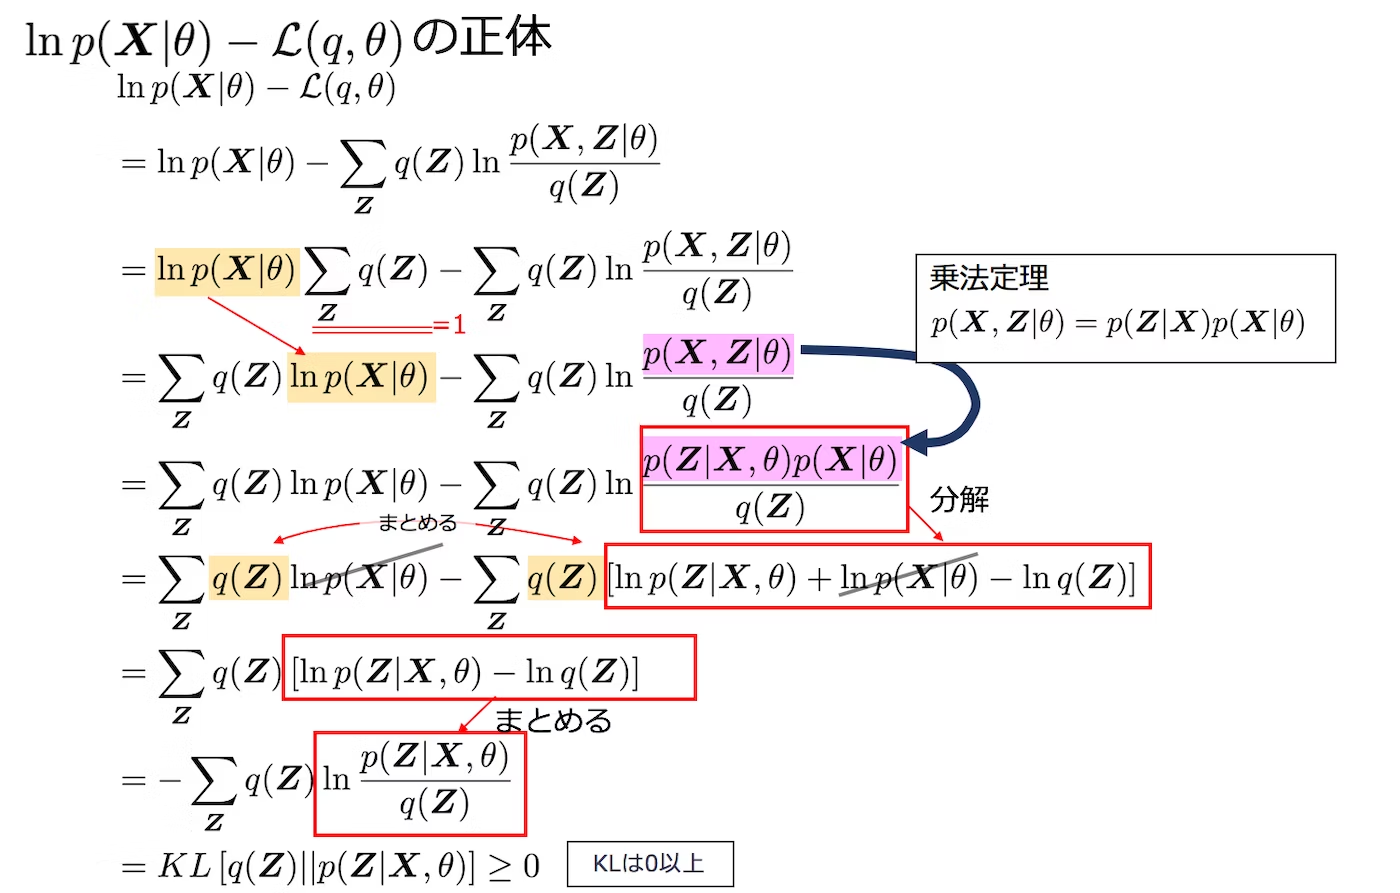
ELBOと似た形である以上、以下のように差分はKLダイバージェンスKL[q(Z)∣p(Z∣X, θ)]KL[q(Z)|p(Z|X, θ)]になる。下図参照。

Image in a image block
log⁡ p(X∣θ) = L(q, θ) + KL[q(Z)∣p(Z∣X, θ)]\log  p(X|θ) = ℒ(q, θ) + KL[q(Z)|p(Z|X, θ)]

KLダイバージェンスは非負なので、 log p(X∣θ)log p(X|θ)ではなく、 L(q, θ)ℒ(q, θ)の最大化を代わりに行うことで結果的に p(X∣θ)p(X|θ)の最大化をしよう!(下限を大きくするので必ず最善というわけではないが)というのがEM Algorithm。

EステップとMステップ

というわけで、目標は以下のELBOを最大化すること。

Eq(Z)[log⁡p(X,Z∣θ)q(Z)]=Eq(Z)[log⁡p(X,Z∣θ)−log⁡q(Z)]\mathbb{E} _{q(\mathbf{Z})} [ \log \frac{p(\mathbf{X}, \mathbf{Z} | \theta)}{q(\mathbf{Z})} ] = \mathbb{E}_{q(\mathbf{Z})} [\log p(\mathbf{X, Z}|\theta) - \log q(\mathbf{Z})]

これを、q,θq, \thetaを交互に動かすことで最大化をしていく。

  • EステップはExpectation。p(X,Z∣θ)p(\mathbf{X,Z}|\theta)のパラメタたるθθを固定して、 qqを動かして最大化をする。
  • MステップはMaximaization。qqを固定して、 θθを動かして最大化をする。

E->M->E->M…と行い、収束したら終了。

Eステップ: qqを動かす

log⁡ p(X∣θ) = L(q, θ) + KL[q(Z)∣p(Z∣X, θ)]\log p(X|θ) = ℒ(q, θ) + KL[q(Z)|p(Z|X, θ)]

この式において、 θθを固定しているので、左辺は定数となる。この時、 qqを動かして L(q, θ)ℒ(q, θ)を最大化するということは、 KL[q(Z)∣p(Z∣X, θ)]KL[q(Z)|p(Z|X, θ)]の最小化と同じ意味である。

KLダイバージェンスが0ということは、解は q(Z) = p(Z∣X, θ)q(Z) = p(Z|X, θ)である。

なので、明示的にqqについて定める必要はなく、既知のp(Z∣X)p(Z|X)がq(Z)q(Z)であればいい。

Mステップ: θ\thetaを動かす

q(Z) = p(Z∣X, θold)q(Z) = p(Z|X, \theta_{old})を代入して解く。ここで、θold\theta_{old}は今までの θθであり、パラメタ θθの最適化を行う際には定数として固定するものである。このように一方を固定してもう一方を最適化するのはよくある手法。

L(q,θ)=∫q(Z)log⁡p(X,Z∣θ)q(Z)dZ=∫p(Z∣X,θold)log⁡p(X,Z∣θ)p(Z∣X,θold)dZ=∫p(Z∣X,θold)log⁡p(X,Z∣θ)dZ−∫p(Z∣X,θold)−log⁡p(Z∣X,θold)dZ=∫p(Z∣X,θold)log⁡p(X,Z∣θ)dZ−const\mathcal{L}(q, \theta) = \int q(\mathbf{Z}) \log \frac{p(\mathbf{X}, \mathbf{Z} | \theta)}{q(\mathbf{Z})} d \mathbf{Z} =\int p(\mathbf{Z} | \mathbf{X}, \theta _{old}) \log \frac{p(\mathbf{X}, \mathbf{Z} | \theta)}{p(\mathbf{Z} | \mathbf{X}, \theta _{old})} d \mathbf{Z} \\\\ = \int p(\mathbf{Z} | \mathbf{X}, \theta _{old}) \log p(\mathbf{X}, \mathbf{Z} | \theta) d \mathbf{Z} - \int p(\mathbf{Z} | \mathbf{X}, \theta _{old}) - \log p(\mathbf{Z} | \mathbf{X}, \theta _{old}) d \mathbf{Z} \\\\ =\int p(\mathbf{Z} | \mathbf{X}, \theta _{old}) \log p(\mathbf{X}, \mathbf{Z} | \theta) d \mathbf{Z} - \mathrm{const}

このように、前半だけ θθで最小化できればよい。つまり、以下の対数尤度の条件付期待値がθにおいて最適化できるということであれば、EMアルゴリズムを用いて最終的に最適解へ収束できる。

∫p(Z∣X, θold)log⁡ p(X, Z∣θ)dZ = 𝔼Z∣X, θold[log⁡ p(X, Z∣θ)]∫p(Z|X, \theta _{old})\log p(X, Z|θ)dZ = 𝔼 _{Z|X, \theta _{old}}[\log p(X, Z|θ)]

解析的に解ける場合

例えば、指数分布族やガウス分布なら解析的に解ける。

ガウス分布の例を時間会ったらここに乗せる。

解析的に解けない場合

積分を近似的に解いてから、勾配を計算し、勾配上昇法やニュートン法でやるしかない。